更新日 2026-08-18
LLMOとは?生成AI検索で引用されるための実践ガイド
LLMO(Large Language Model Optimization)とは、ChatGPTやGeminiなどの生成AIが作る回答で、自社の情報を正しく理解・言及・引用できる状態を整える取り組みです。従来のSEOを捨てる施策ではありません。検索エンジンに発見される土台を維持しながら、AIクローラーのアクセス、明確なブランド情報、引用しやすい回答、第三者による裏付けを整えます。成果は固定したプロンプト群の言及率・引用率・シェア・オブ・ボイスで測定します。
LLMOには、検索順位を直接上げる裏技も、掲載を保証する特別な設定もありません。Googleも生成AI検索について、従来のSEO基盤と役立つ独自コンテンツが引き続き重要だと説明しています。実務では「読める」「理解できる」「根拠として使える」「結果を測れる」の4条件を順番に整えるのが最短です。本記事では、LLMOとSEO・GEO・AEOの違いから、6つの対策、4週間の進め方までをまとめます。
LLMO(LLM SEO)とは
LLMOは、生成AIの回答におけるブランドの見つかりやすさと引用されやすさを改善する継続的な運用です。対象には、自社サイトの技術的なアクセス性、ブランドや商品の説明、記事・ドキュメントの構造、外部サイト上の情報、そして回答結果の計測が含まれます。
「LLMO」は業界で使われる実務用語であり、統一された公式規格ではありません。生成エンジン最適化(GEO)や回答エンジン最適化(AEO)と大きく重なります。呼び方より、対象チャネルと成果指標を明確にすることが重要です。
| 用語 | 主な目標 | 代表的な指標 |
|---|---|---|
| SEO | 検索結果で発見され、クリックされる | 掲載順位、表示回数、クリック、自然検索コンバージョン |
| LLMO | LLMベースの回答で理解・言及・引用される | 言及率、引用率、推薦率 |
| GEO | 複数の生成AI検索体験で可視性を得る | プラットフォーム別の可視性、シェア・オブ・ボイス |
| AEO | 質問に対する明確な回答として選ばれる | 回答枠、引用、強調スニペット |
SEOはLLMOの前提です。GoogleのAI OverviewsやAI Modeに出るには、ページがGoogle検索でインデックスされ、スニペット表示の対象になっている必要があります。ChatGPT検索ではOAI-SearchBotを許可することが発見性の前提になります。どちらも「専用ファイルを置けば上位に出る」という仕組みではありません。
AI検索が回答と引用を作る仕組み
AIの回答には、モデルが学習済みの知識を使う場合と、回答時にウェブ検索などで情報を取得する場合があります。どの情報源が使われ、どのようにリンクが表示されるかは、プラットフォームと質問によって変わります。公開されていないランキング式を推測するより、確認できる流れに沿って対策する方が実用的です。
1. 質問を解釈する。 AI検索は、ユーザーの質問をそのまま扱うだけでなく、必要に応じて関連する検索語へ言い換えます。ChatGPT検索も、検索パートナーへ送るために質問を複数の具体的なクエリへ書き換える場合があると説明しています。
2. 関連ページを取得する。 検索連動型の回答では、検索インデックスやクローラーが取得できる公開ページが候補になります。Googleの生成AI検索はコア検索システムを使い、ChatGPT検索ではOAI-SearchBotのアクセス可否がコンテンツ表示に影響します。
3. 回答に使う情報を選ぶ。 取得されたページのうち、質問への関連性、内容の明確さ、信頼性、鮮度などを各サービスの仕組みで評価します。詳細な選定式は公開されておらず、要件を満たしても掲載は保証されません。
4. 回答とリンクを生成する。 選ばれた情報を要約し、対応するリンクや参照元を表示します。同じプロンプトでも回答と引用は変動するため、1回の確認ではなく固定プロンプトの継続測定が必要です。
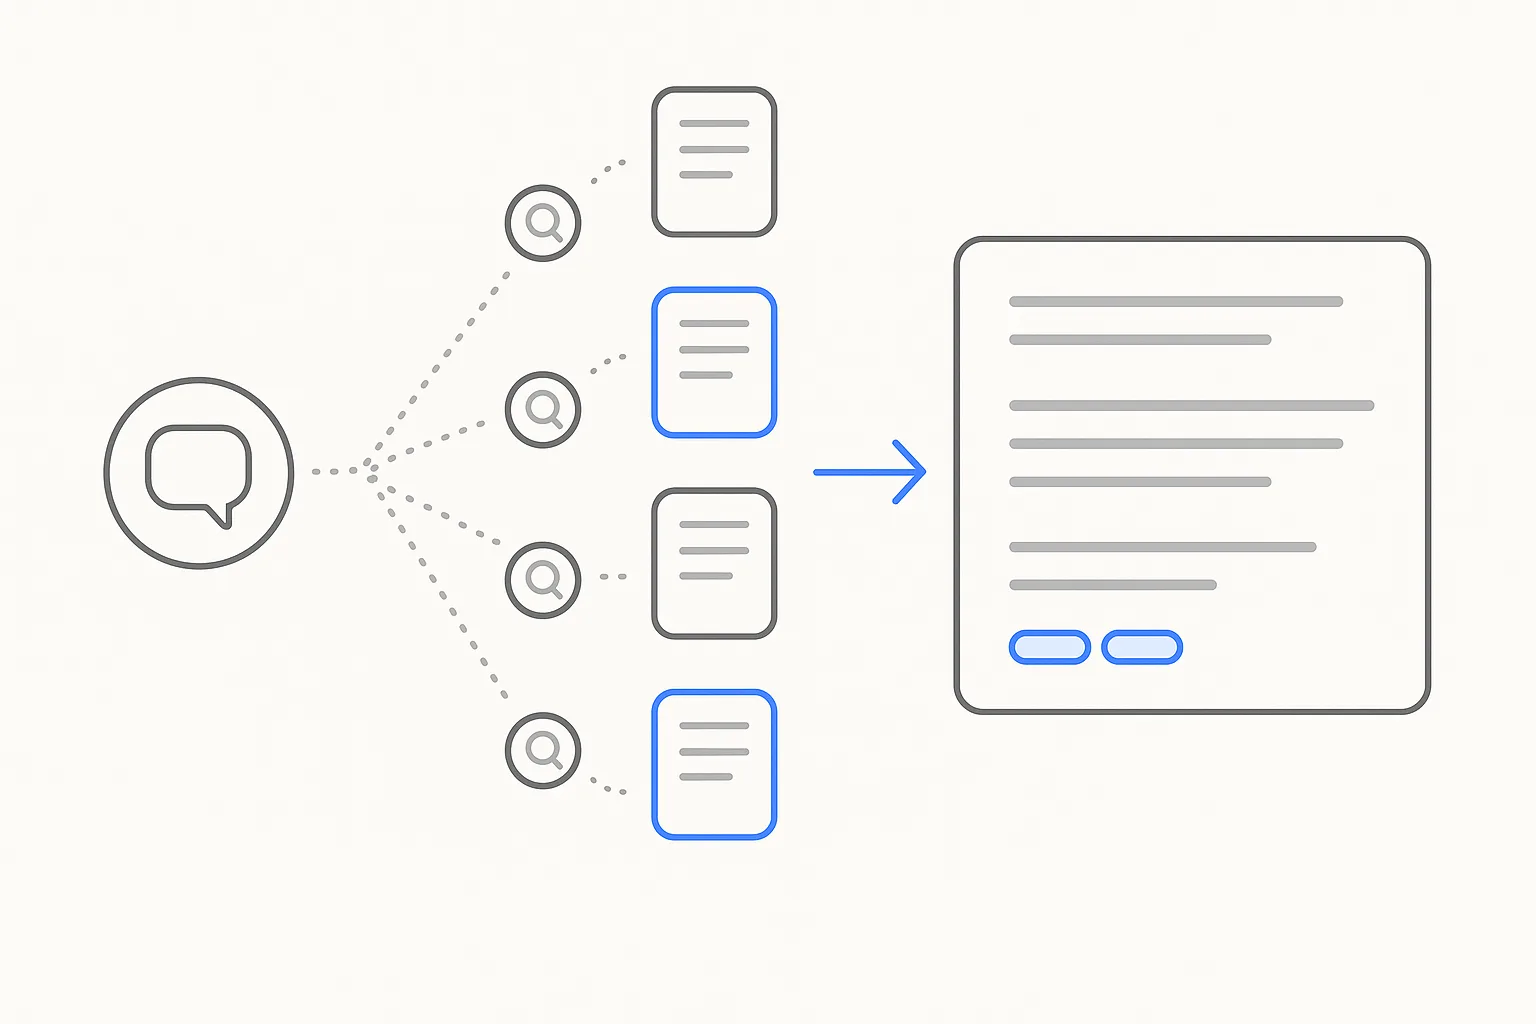
マーケターが改善できるのは、取得候補に入れる技術基盤と、取得後に使いやすい情報の質です。具体的には、クローラーが読める状態、統一されたブランド情報、質問に直接答える文章、検証可能な根拠、そして外部サイトとの事実の一貫性を整えます。
LLMOのやり方:6つの対策
以降で解説する要素はどれも地味ですが、それこそが本質です。必要なのは裏技(グロースハック)ではなく、エンジンが実際に参照する場所に対して適切な情報発信を愚直に行うことです。各要素は相互に相乗効果を生み出すため、順番に対策を進めてください。初期段階の要素に不備があると、それ以降の施策効果が頭打ちになります。
1. マシンからのアクセス性(クローラー、robots.txt、JavaScript)
アクセス権限: クローラーがコンテンツを読み込めなければ、AI検索エンジンにとってそのページは存在しないも同然です。robots.txtやmeta robotsタグを確認し、一般的な検索エンジンボットと主要なAI専用クローラーの双方が重要ページを取得(フェッチ)できるように設定してください。また、ディレクトリ単位の過度なdisallow指定によって、ドキュメントや料金ページが意図せずブロックされていないか注意が必要です。主要5大AIクローラーの横断比較データについては、AIクローラーのアクセス性ベンチマークを参照してください。
サーバーの挙動: ヘッドレス環境でのフェッチテストを実施し、ステータスコード200、適切なContent-Type、そしてクライアントサイドレンダリング(CSR)に依存しない完全なHTMLが返されるか確認してください。主要コンテンツの描画にJavaScriptが必要な場合は、サーバーサイドレンダリング(SSR)や事前レンダリング(プリレンダリング)によるスナップショットを提供します。ブラウザ上では正常に見えても、クローラーからは「空」と認識されてしまうページが多いため、AI可読性診断による事前検証が不可欠です。
サイトマップとフィード: 正確なlastmod(最終更新日)を付与したXMLサイトマップを提供し、技術ドキュメントや更新履歴(Changelog)にはRSS/Atomフィードを設定して、情報の鮮度(フレッシュネス)をシグナルとして伝えます。
アクセスの安定性: 自動化されたクライアントを遮断するインタースティシャル広告、Cookie同意ウォール、過度なレート制限は最小限に抑えてください。アセットの読み込みが遅いと、ヘッドレスレンダラーがタイムアウトし、ページが空であると判定される原因になります。
2. エンティティの明確さ
曖昧さの排除(ディスアンビギュエーション): ブランド名が他社製品や一般名詞と同じ場合、AIが別の対象として解釈する可能性があります。自社サイトや外部プロフィール全体で正式名称、事業概要、タグラインを統一し、混同しやすいページには区別のための説明を1文明記します。
構造化データのシグナル: OrganizationやProductのスキーママークアップを活用して、正式名称、別名、sameAsプロパティによるSNSアカウントや外部プロファイルの関連付けを明示し、ソーシャルハンドルの表記やドメインの一貫性を保ちます。具体的な実装パターンについては、AI検索エンジンが「自社」を特定する仕組みで解説しています。
ランディングページの構造化: 各エンティティに対して恒久的な固有URLを1つ用意し、「何であるか」「誰向けか」「どう使うか」をスキャンしやすい構成ブロックで簡潔に記述します。また、関連するエンティティ同士を適切に内部リンクで結ぶことで、AIのクラスタリング処理を有利に働かせます。
3. 引用されやすいコンテンツ構造
単体で引用可能な単位(リフタブル・ユニット): AIエンジンは、ページ全体の文脈がなくても単体で成立・抽出できるパッセージを好みます。1文で言い切る定義、手順の番号付きリスト、簡潔な比較テーブルの行、具体的な価格や制限事項などが該当します。これらはページ上部に配置し、見出しラベルを明確にしてください。
結論優先のライティング(Answer-first): スクロールしなくてもモデルが回答を即座に抽出できるよう執筆します。疑問形の見出し、短い段落、明確な断定表現と具体的な数値を含む要約ブロックを活用してください。ライティングの詳細なルールについては、AIエンジンに引用されるコンテンツの書き方を参照してください。
テキスト抽出の阻害要因を排除: Cookieウォール、メールアドレスの入力ゲート、テキスト抽出を妨げるスクリプトを排除し、コンテンツを常に取得可能にしておきます。また、正規版(canonical)のページを最もクリーンでプレーンな構造に保ってください。
4. 第三者による裏付け(外部プレゼンス)
ドメインをまたぐ事実の一貫性: 自社だけが主張する情報より、公式プロフィール、パートナー、業界ディレクトリなどでも同じ基本情報を確認できる方が、読者にもAIにも検証しやすくなります。目指すべきはマーケティングコピーの複製ではなく、社名、カテゴリ、機能、料金などの事実の一致です。
エビデンスの深さ: 製品仕様は技術ドキュメント、制限はサポート記事、金額は料金ページというように、主張ごとに確認できる一次情報源を用意します。自社サイトと外部プロフィールの内容が一致していれば、古い情報や別ブランドとの混同も減らせます。
想定プロンプトのフレームワーク: ユーザーからのプロンプトの多くは、「Yに最適なX」「Zの代替製品」「X対Y」といった形式で入力されます。誇大広告を避け、客観的かつ明確に記述された比較フレームワークを、AIが検索・取得できる場所に用意してください。
5. 情報の鮮度と検索性(リトリーバビリティ)
更新経路の整備: リアルタイム検索を行うAIエンジンは、サイトマップやフィードを定期的に再クロールします。lastmodやpubDateを正確に設定し、ページ上にも目視できる「最終更新日」を明記することで、抽出されたスニペットに情報の鮮度を示すシグナルを持たせます。
HTTPの健全性: 正規(canonical)URLを安定させ、URL変更時は301リダイレクトを適用し、ソフト404を排除します。「あるページには旧料金、別のページには新料金」のような不整合は、検索エンジンやAIだけでなく読者の判断も妨げます。
クロールに適した構造設計: クロールさせたい一覧・インデックスページでは無限スクロールを避け、前後関係を示す明確なリンク(next / previous)を備えたページネーション付きアーカイブを提供してください。
6. プラットフォームごとの挙動の違い
ChatGPT: ブラウジング機能が有効な場合、Web上の複数ソースへクエリを展開し、インライン引用を限定的に表示します。技術的なクエリに対しては、簡潔な定義文や公式ドキュメントが好まれる傾向があります。具体的な対策法は、ChatGPTに引用される方法で解説しています。
Google AI Overviews(AIによる概要)およびAI Mode: 学習コーパス内の知識と、Googleインデックスに基づくリアルタイム検索(グラウンディング)を統合して回答を生成します。そのため従来のクロール性や品質要件がそのまま適用されますが、引用単位は検索順位リストではなく「回答パラグラフ」となります。グラウンディングの仕組みについては、AI Overviewsを参照してください。
Gemini、Perplexity、Bing Copilot: 各プラットフォームは、それぞれ異なるリトリーバー(情報取得エンジン)、UI制約、引用ポリシーを持っています。ドメインの多様性を重視するもの、鮮度をより高く評価するもの、インラインではなく文末にまとめて参照元を表示するものなど様々です。同一のプロンプトであっても結果はプラットフォームごとに異なります。基本となる4つのインプット(アクセス性、エンティティの明確さ、引用されやすい構造、外部による裏付け)を共通の基盤としつつ、各エンジンを個別のチャネルとして捉えて最適化を進めてください。
LLMO対策の始め方:4週間の実践プラン
LLM SEOは、4週間のサイクルを基本単位として継続的に回す運用が効果的です。このサイクルを維持することで、見込み顧客にとって重要なプロンプトにおける測定可能な変動を常に捉え続けられます。
今週1時間しか時間が取れない場合は、第1週の簡易版だけでも実施してみてください。購買プロンプトを10個選び、2つのエンジンで実行して、その回答を後から確認できる場所に保存します。「誰の名前が挙がっているか」「誰が引用されているか」「自社がどこで抜け落ちているか」というこの1回のベースライン調査だけでも、コンテンツロードマップ全体の再設計につながります。以下のプログラムは、それをスケールさせたものに過ぎません。
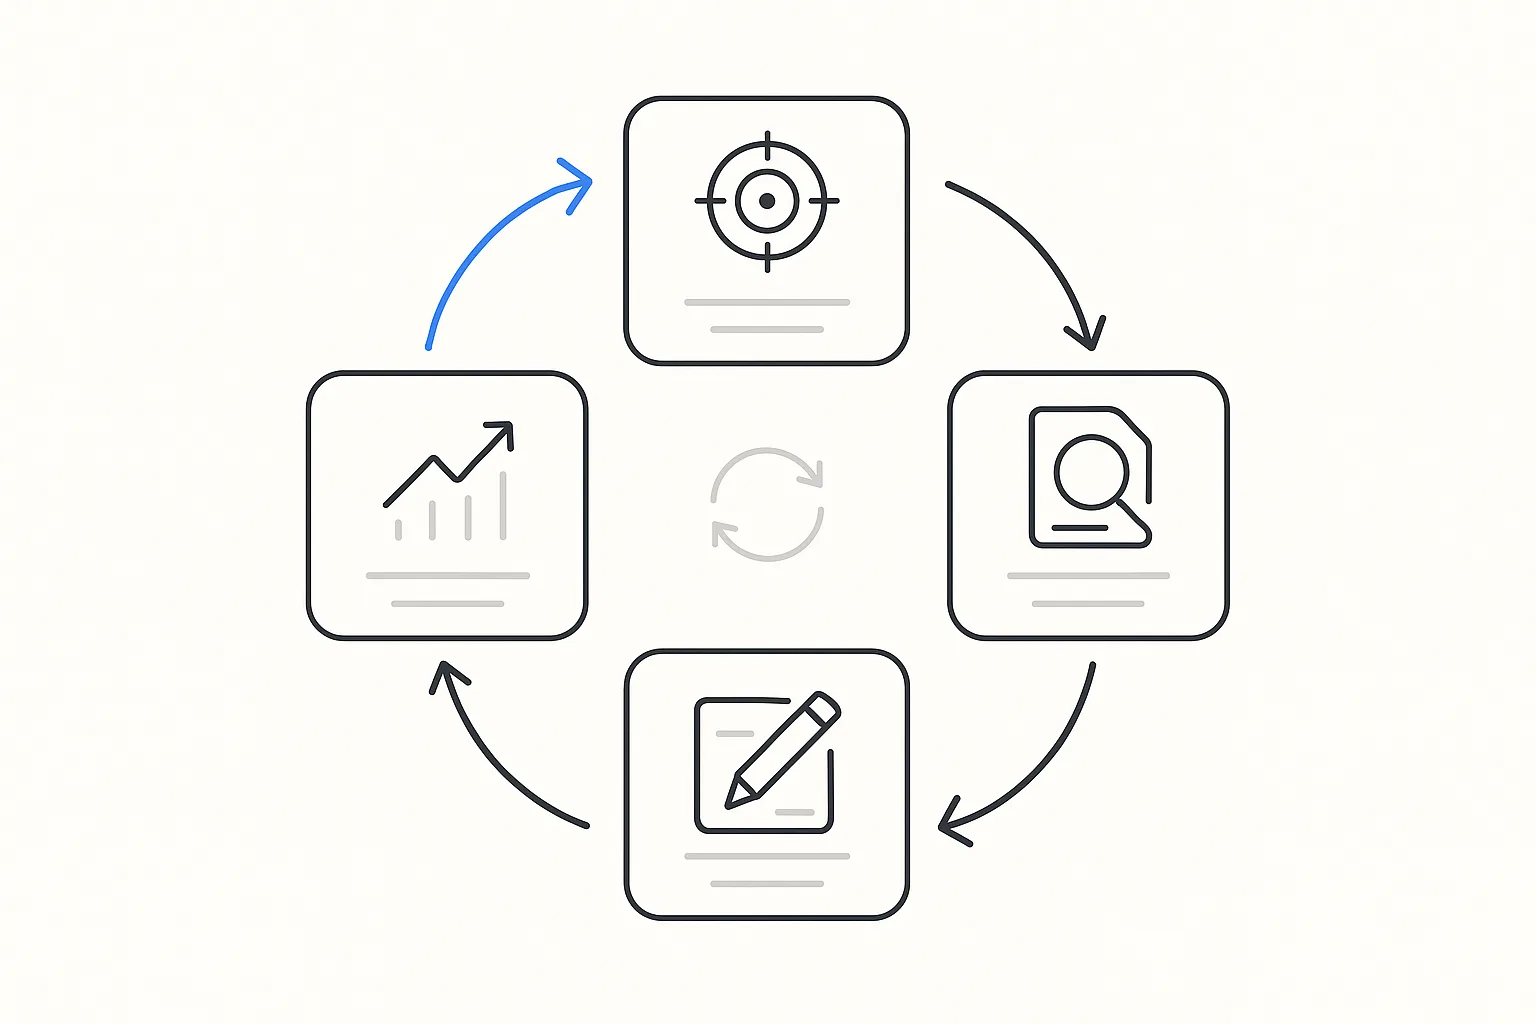
第1週:ベースライン測定とプロンプトセットの定義
プロンプトセットを定義する。 まずは自社の商談機会に直結する10〜25個のプロンプトから始めます。「[カテゴリ]とは」「[セグメント]向けおすすめ[カテゴリ]」「[競合]の代替ツール」「[自社ブランド] vs [競合]」などが挙げられます。抽出の詳しい手順は、AI検索で顧客が使う購買プロンプトの見つけ方で解説しています。
ベースラインを測定する。 対象とする各エンジンでプロンプトを実行し、回答内容、引用された情報源、自社ブランドへの言及・リンク・推奨の有無を記録します。必ずエビデンス(回答データ)を保存してください。後から再確認できない回答データは、組織内で根拠として提示できません。
数値を算出する。 エンジン別および検索意図の分類ごとに、プロンプトセット全体の引用率とシェア・オブ・ボイスを計算します。このベースラインが、今後のあらゆる施策効果を測る基準となります。
第2週:アクセス性とエンティティの監査
クロール性の検証。 引用を獲得すべき重要ページについて、robots.txt、canonicalタグ、サイトマップの網羅性、サーバーレスポンスを確認します。さらにヘッドレス環境で取得し、JavaScriptなしでも主要コンテンツがレンダリングされるかを検証します。サイト監査ツールを使えば、このチェック項目を自動化できます。
エンティティの一貫性。 正式名称や説明表現を統一し、OrganizationやProductの構造化マークアップを更新します。必要に応じて同音異義語や類似概念と区別する記述を追加し、関連するエンティティページ間を相互リンクで結びます。
検索・抽出対象ページの整備。 ドキュメント、料金表、比較ページが独立した固有URLと明確なタイトルを持つように整備し、更新頻度が高いコンテンツにはフィードを用意します。
第3週:ギャップを埋めるコンテンツの公開
定義の不足を解消する。 自社のカテゴリやプロダクトに関する「[X]とは」の定義ブロックを新規作成またはリファクタリングします。AIがそのまま抽出しやすい比較表の行や、具体的な数値を盛り込みます。
外部による裏付けを構築する。 自社の公式な説明文が反映されるよう外部のまとめサイトやレビューサイトの掲載情報を更新し、パートナー企業には正確なリンクを含む定型紹介文を共有します。
過密なページを分割する。 1つのURLで多くの検索意図をカバーしようとしているページは分割し、各ページが特定のプロンプトクラスターに明確に対応するようにします。タイトルやH1タグも、ターゲットとするプロンプトの表現に合わせます。
第4週:再測定と改善
プロンプトセットを再実行する。 エンジン別およびプロンプトクラスター別に、引用率とシェア・オブ・ボイスの変動幅を比較します。新しく追加された箇所、脱落した箇所、競り負けた情報源を詳細に分析します。
欠落の原因を診断する。 自社が表示されなかったプロンプトについて、「クローラーがページに到達できたか」「抽出可能な回答ユニットが含まれているか」「その主張を裏付ける外部情報があるか」の順に確認します。失敗の原因は、ほぼこの3つのいずれかにあります。
運用ループを定着させる。 診断結果を次期スプリントの公開タスクに落とし込み、月次の再測定リズムを維持します。また、定義ブロックのブラッシュアップや古い数値の更新といった即効性のある改善のために、毎週一定の作業時間を確保します。
LLMOの効果をどう測るか
LLMOは検索順位だけでは評価できません。まず、見込み顧客が実際に使う固定プロンプトを用意し、プラットフォーム、言語、地域、実行頻度を変えずに記録します。比較する主な指標は次の4つです。
- 言及率: 対象回答のうち、自社ブランド名が登場した割合。
- 引用率: 対象回答のうち、自社ドメインへのリンクが表示された割合。
- 推薦率: 自社が候補、比較対象、推奨サービスとして扱われた割合。
- シェア・オブ・ボイス: 定義した競合集合の全ブランド言及に占める自社の割合。
7日間の変化は実行漏れや急な回答変化の検知に使い、28日間の変化で施策の方向性を判断します。数値が動いたら、集計だけでなく元の回答、引用URL、実行日時まで戻って原因を確認してください。計算式と読み方はAI検索での可視性指標で詳しく解説しています。
LLMOに専用ツールは必要か?
対象規模が小さい段階であれば、手動でも基本的な運用は可能です。1〜2種類のエンジンで十数個から20個程度のプロンプトを定期的にチェックし、スプレッドシートにエビデンスを記録していく形です。しかし、この手作業での運用には限界があります。エンジン、プロンプト、地域、関係者の数が増えると、手法そのものは同じであっても、データ管理の負荷に耐えられなくなって破綻します。
専用ツールを導入することで、大規模な運用でも再現性を確保できます。主要エンジン全体での定期実行、エビデンスの自動保存、エンジン別のシェア・オブ・ボイスや引用率の集計、プロンプトクラスターごとのギャップ検出などが自動化されます。AEO Mantisは、ChatGPT、Gemini、Perplexity、AI Overviews、AI Mode、Bing Copilotを横断した単一のワークフローとしてこれらを提供します。無料枠の範囲や有料プランの詳細は料金プランをご確認ください。
- LLMOはSEOの代替ではありません。Googleの生成AI検索でも、インデックス可能で役立つコンテンツというSEOの基盤が必要です。
- ChatGPT検索にコンテンツを表示させたい場合は、OAI-SearchBotをブロックしていないか確認します。GPTBotの学習設定とは別です。
- 短く明確な定義、比較表、手順、一次情報は、回答の根拠として使われる箇所を人にもAIにも分かりやすくします。
- 同じ質問でも回答と引用は変動するため、固定したプロンプト、言語、地域、プラットフォームで継続測定します。
- 成果は言及率、引用率、推薦率、シェア・オブ・ボイスを分けて確認し、必ず元の回答と引用URLまで保存します。
よくある質問
実務では大きく重なります。LLMOは大規模言語モデルを中心に説明する言葉、GEOは検索や引用UIを含む生成エンジン全体を中心に説明する言葉です。社内では対象プラットフォームと測定指標を統一する方が重要です。
はい。Googleの生成AI検索では、ページがGoogle検索にインデックスされ、スニペット表示の対象であることが前提です。クロール性、内部リンク、役立つ独自コンテンツ、正確な情報はLLMOでも土台になります。
Web検索を行うエンジンの場合、アクセス性・構造・コンテンツを改善すれば、再クロール後数日から数週間で結果に反映されることがあります。一方、モデル自体の記憶に依存する回答の場合は、次の学習サイクルを待つ必要があります。プロンプトセット全体の安定した推移を捉えるには、月次での測定サイクルが現実的です。
小規模であれば可能です。固定したプロンプトセット、1〜2種類のエンジン、週次の測定スケジュールを決め、スプレッドシートに確実にエビデンスを記録していきます。ただし、プロンプト数、対象エンジン、関与するステークホルダーが増加し、手作業での記録漏れやエビデンスの消失が発生し始めたら、専用ツールの導入が費用対効果に見合うようになります。
見込み顧客が実際に情報収集で利用しているプラットフォームから着手します。多くのB2B企業にとっては、まずChatGPTとGoogleのAI Overviews、次いでPerplexity、あるいは自社の業界でよく使われているエンジンが対象となります。最初から全プラットフォームに手を広げるのではなく、小規模なパイロットプロンプトセットで検証することをおすすめします。
あります。狭い用途や業界の質問では、具体的な一次情報、明確な製品説明、検証可能な事例を持つページが候補になり得ます。ただし掲載は保証されないため、重要なプロンプトに絞って言及と引用を継続測定してください。