更新於 2026-08-18
2026 AI 能見度工具比較:如何選對平台
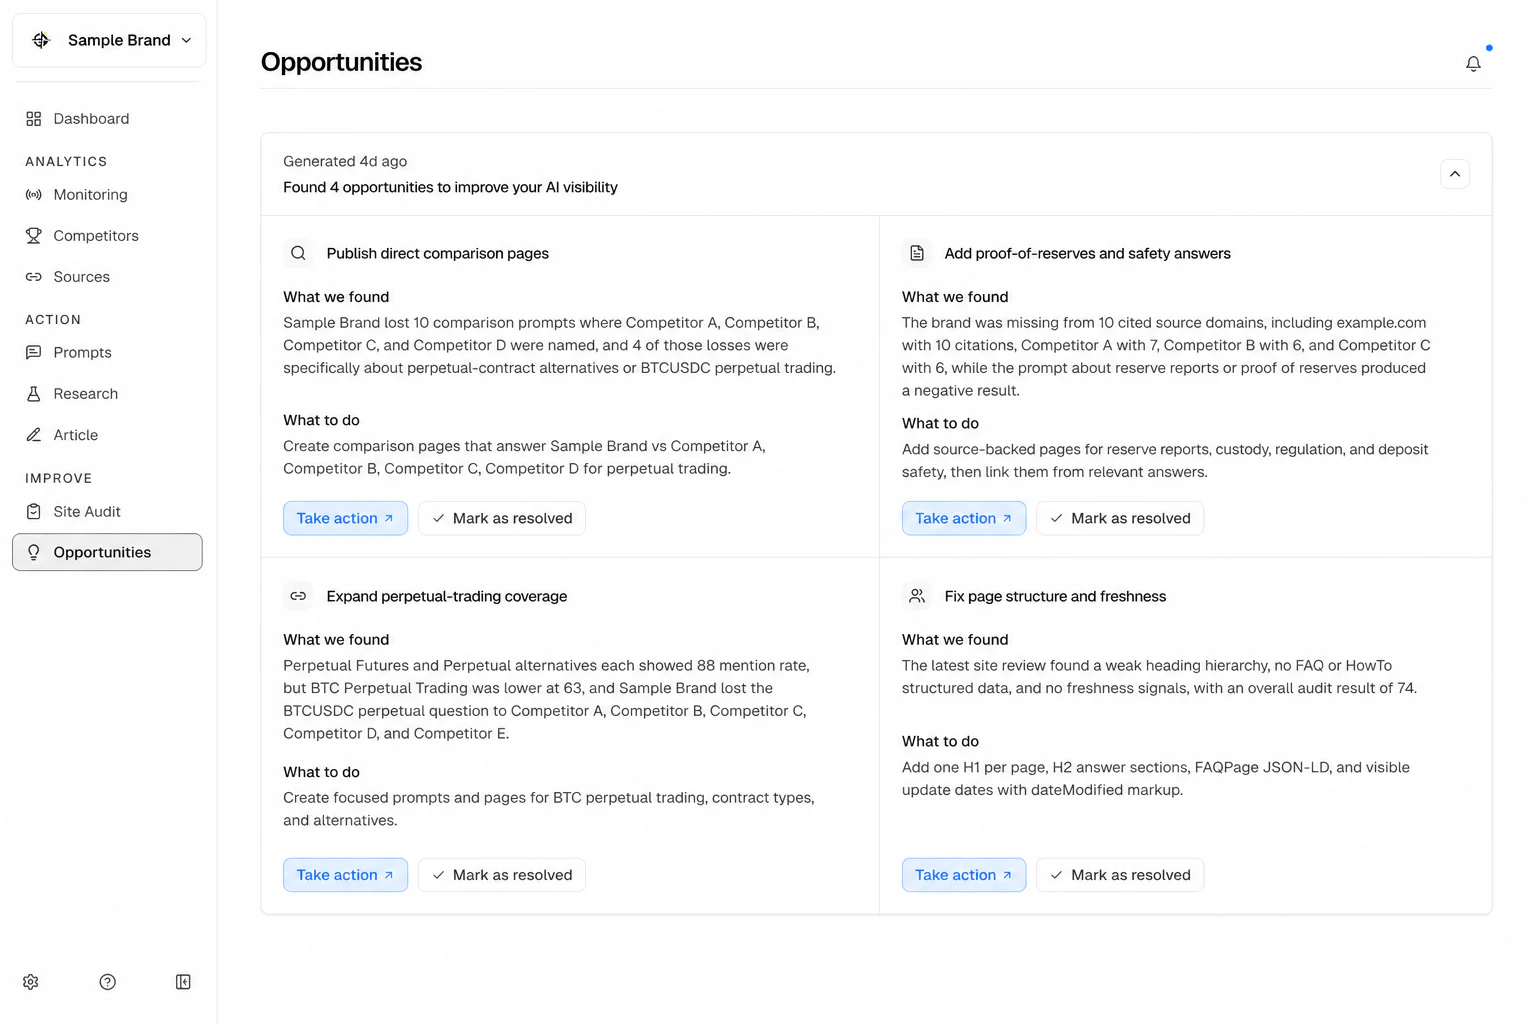
沒有一款 AI 能見度工具適合所有團隊,重點是它能否支援你每週要做的決策。精簡團隊若希望把監測、網站稽核、研究和內容行動放在同一套流程,可優先評估 AEO Mantis;大型企業的完整 AEO 計畫可看 Profound;需要先從大量市場資料找機會,可看 Ahrefs Brand Radar;已採用 Semrush 的團隊可評估其 AI Visibility Toolkit;重視提示詞、競爭對手與來源分析,可看 Peec AI;若核心需求是輕量監測,則可考慮 OtterlyAI。試用時必須固定提示詞、平台、語言與地區,否則比較結果沒有意義。
AI 能見度工具用來觀察品牌是否出現在 ChatGPT、Gemini、Perplexity、Google AI 搜尋體驗、Copilot 等答案介面,是否獲得引用,以及是否被列為合適選項。市場變化很快,但選購原則沒有變:任何百分比都必須能追溯到產生它的提示詞、回答和來源。
這篇指南不是要選出唯一冠軍,而是按工作流程比較六個平台。文中功能依各品牌在 2026 年 8 月 17 日公開的產品頁與說明文件整理。價格、平台涵蓋與方案限制可能隨時調整,正式採購前仍應在試用或銷售評估中確認。
揭露:本指南由 AEO Mantis 發布。沒有任何品牌付費入選;所有產品均以相同的證據與工作流程標準評估。
六款 AI 能見度工具快速比較
| 工具 | 適合納入名單的情況 | 公開功能重點 | 試用時要確認 |
|---|---|---|---|
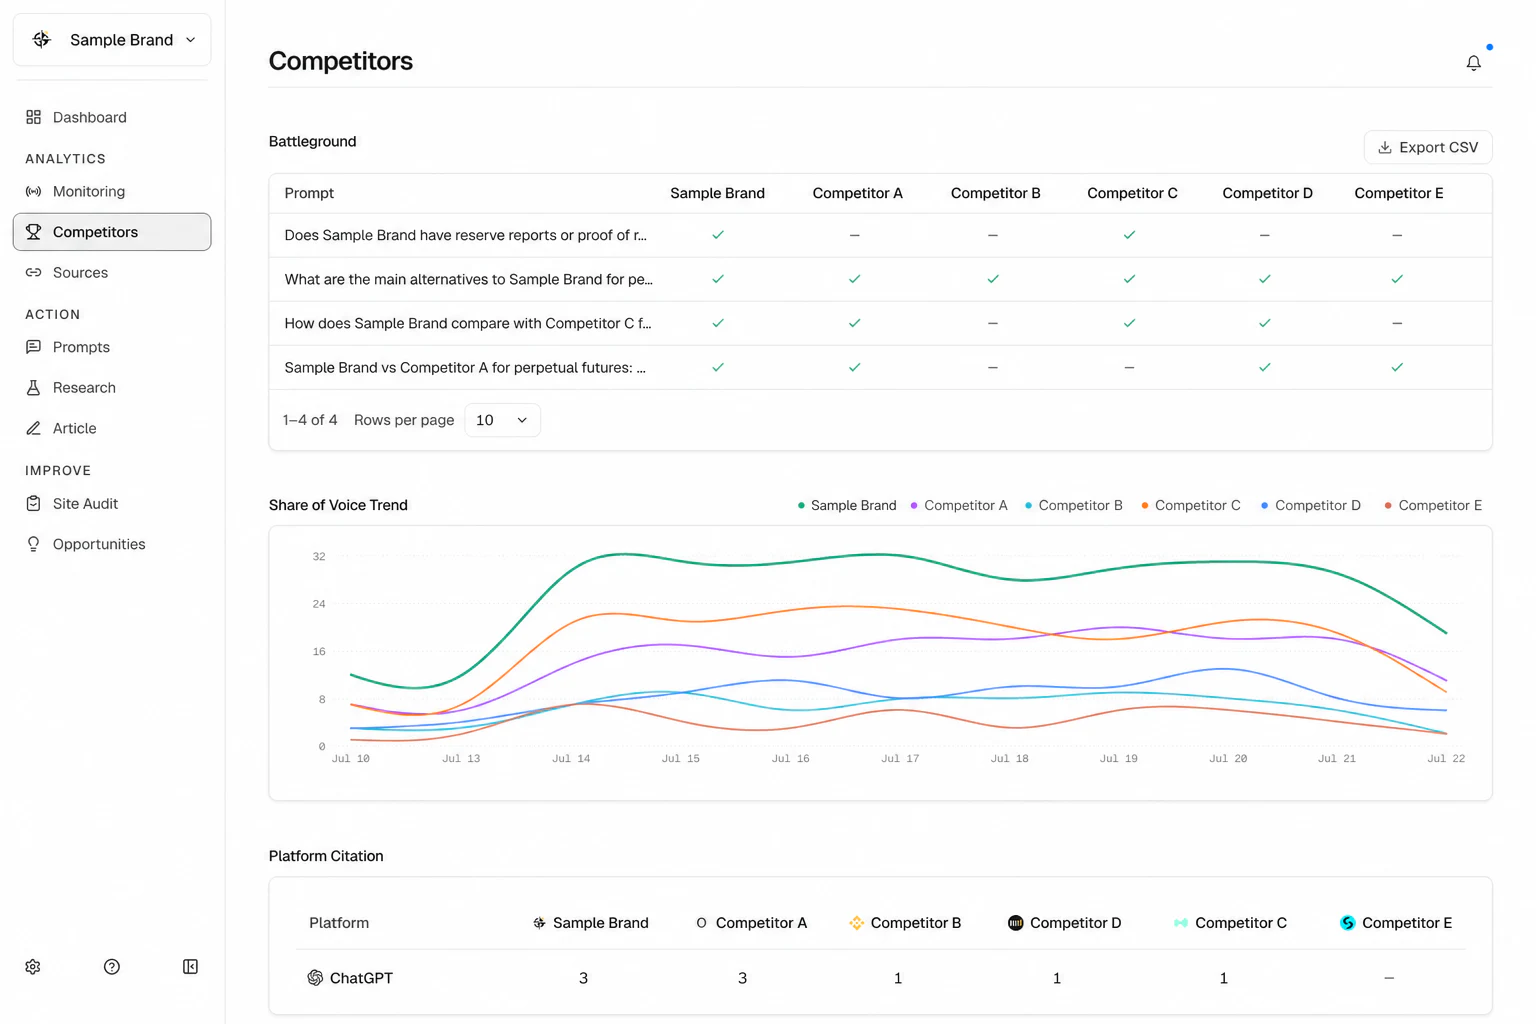
| AEO Mantis | 精簡團隊希望從監測證據直接走到技術或內容行動,不想拼接多套工具 | 自訂提示詞監測、保存回答與引用、分開計算提及與引用、競爭分析、網站稽核、研究、機會清單與內容流程 | 方案涵蓋的平台、提示詞額度和報告頻率是否符合你的市場組合 |
| Profound | 企業級計畫需要提示詞需求研究、答案引擎監測、爬蟲分析與自動化內容流程 | Prompt Volumes、Answer Engine Insights、伺服器記錄 Agent Analytics、競爭基準與 Content Agents | 實際會採用的模組需要哪些導入工作、治理和方案權限 |
| Ahrefs Brand Radar | 希望先從大型搜尋型提示詞資料庫探索市場,再建立自訂追蹤組合 | 涵蓋七個 AI 平台的大型索引資料、品牌與競爭研究、被引用頁面與網域、跨渠道來源及自訂提示詞 | 應以索引資料庫還是自訂提示詞作為主要基準 |
| Semrush AI Visibility Toolkit | 團隊已使用 Semrush,希望把 AI 能見度接入既有 SEO 工作流程 | 品牌基準、提示詞研究與追蹤、競爭缺口、情緒、引用來源、地區資料和 AI 網站檢查 | 所選方案包含的網域、地區、提示詞、匯出與使用者權限 |
| Peec AI | 週會以具體提示詞、競爭變化、品牌位置、情緒和引用來源為中心 | 每日提示詞執行、能見度與位置趨勢、競爭比較、來源分析、近期回答和行動建議 | 模型、國家、語言、匯出和整合是否符合報告需要 |
| OtterlyAI | 小型團隊或代理商需要較聚焦的提示詞監測、品牌報告與引用追蹤 | 提示詞監測、品牌與網域報告、引用追蹤、競爭能見度,以及六個公開列出的 AI 搜尋介面 | 核心監測以外的研究與最佳化深度是否足夠 |
這六款工具量度的並不是同一種資料。Ahrefs 偏向大規模市場探索;提示詞監測工具則著重由團隊定義的固定面板。Profound 把答案引擎數據、伺服器記錄分析和自動化結合;Semrush 將 AI 報告接入更大的 SEO 套件;AEO Mantis 則把監測證據連到稽核、研究與內容工作清單。應先決定團隊每週要完成哪項工作,再選工具。
我們如何評估這些工具
好的工具比較,應先定義團隊需要哪些證據才能重現結果。我們以八項要求評估從量度到行動的完整路徑。
| 要求 | 為什麼重要 | 試用時要問 |
|---|---|---|
| 提示詞控制 | 固定買家問題,並把探索問題與品牌指名檢查分開 | 能否保留完整提示詞、主題、語言、地區和納入規則? |
| 完整回答證據 | 讓每次圖表變動都能追溯到造成變化的回答 | 能否打開成功、缺席、無引用和失敗的回答? |
| 分開計算指標 | 避免把提及、引用、推薦、位置和情緒混成模糊分數 | 能否查看每個主要指標的分子與分母? |
| 平台與市場控制 | 呈現平台、語言和地區差異,不用不相同的資料硬算平均 | 能否分別篩選及匯出平台、語言、國家和日期? |
| 競爭情境 | 找出哪些品牌拿走你缺少的提及與引用 | 能否打開競爭對手勝出的提示詞與來源? |
| 技術診斷 | 在重寫內容前先找出爬取、渲染、metadata 和實體問題 | 工具會檢查頁面,還是只報告回答結果? |
| 機會排序 | 把缺少的能見度變成有先後次序的工作清單 | 能否把發現轉成包含頁面、理由和量度期間的負責任務? |
| 研究與內容流程 | 把輸掉的回答接到有來源支持、可爭取引用的頁面 | 能否在刷新內容時保留原本的提示詞與來源證據? |
平台數量本身是很弱的選購標準。只有在每次執行都保存足夠證據、能支持下一個決策時,平台涵蓋才有價值。追蹤介面再多,若無法查看回答,實務價值可能低於一套規模較小但證據完整的面板。
哪款 AI 能見度工具適合你的使用情境?
AEO Mantis:適合精簡團隊的量度到行動流程
AEO Mantis 把提示詞設定、回答與引用、競爭比較、網站稽核、研究和下一項行動放在同一個操作循環。方案涵蓋的答案介面不同,但結果會按平台分開。免費方案從單一品牌的五個 ChatGPT 提示詞啟動掃描開始。
它的重點不是提供一個無法解釋的總分,而是保留可控制的提示詞範圍、分開提及與引用,並讓團隊打開底層回答。當數字移動時,團隊可以判斷下一步應該是技術稽核、刷新現有頁面,還是建立新內容。
Profound:大型企業的完整 AEO 營運
Profound 把多個企業級 AEO 工作流程放在同一套產品中,包括真實使用者提示詞需求資料、每日答案引擎能見度與引用分析、伺服器記錄中的爬蟲和引薦流量,以及可設定的 Content Agents。若研究、分析、基礎設施和發布由不同部門負責,這種範圍會更有價值。
採購時要問的是實際需要哪些模組。只想追蹤一小組提示詞的團隊未必需要完整套件,應確認方案包含哪些整合、控制、導入支援與資料權限。
Ahrefs Brand Radar:大規模市場探索
Ahrefs Brand Radar 以涵蓋七個 AI 平台的大型搜尋型提示詞索引為核心,亦提供自訂提示詞追蹤。它適合在新面板累積歷史前先探索市場、比較大量品牌,並把 AI 提及與引用接到網頁、Reddit、YouTube 和 TikTok 能見度。
索引資料和自訂提示詞回答的是不同問題。前者用來發現需求和競爭對手;後者用來固定量度團隊真正負責的買家問題。
Semrush AI Visibility Toolkit:既有 SEO 套件中的 AI 資料
已在 Semrush 工作的團隊,可把 AI Visibility Toolkit 納入評估。它結合品牌基準、提示詞研究與追蹤、競爭和情緒分析、引用來源機會、地區資料,以及針對 AI 的網站檢查。
不要假設既有 Semrush 訂閱已包含所有功能。網域、地區、提示詞數量、匯出和使用者權限會依工具包與方案而異。
Peec AI:提示詞、競爭對手與來源分析
Peec AI 的工作流程圍繞每日提示詞執行,以及能見度、平均位置、情緒、競爭對手和引用來源之間的關係。團隊可查看近期回答、辨認影響類別的來源,並找出競爭對手有出現而品牌缺席的主題。
若週會從具體提示詞和來源變化開始,這種設計很合適。建立全球基準前,仍要確認所需市場、語言、模型和整合是否涵蓋。
OtterlyAI:小型團隊與代理商的聚焦監測
OtterlyAI 提供提示詞研究、每日監測、品牌報告、引用與網域追蹤,以及 ChatGPT、Google AI Overviews、Perplexity、Google AI Mode、Gemini 和 Microsoft Copilot 的競爭能見度。產品範圍較聚焦,適合主要需要監測與報告的小型行銷團隊或代理商。
試用時要測試「發現問題之後」的流程。如果團隊同時需要技術診斷、研究或正式內容製作,應確認 OtterlyAI 的最佳化功能是否足夠,或是否需要另一套系統負責行動。
應該如何試用 AI 能見度工具?
以一組固定、能代表真實購買決策的提示詞進行小型測試。15 至 20 個提示詞已足以暴露工作流程缺口,不必把評估拖成一季。應涵蓋類別探索、使用情境、比較、導入、價格、風險和信任。
至少七天使用相同的提示詞文字、平台、語言、地區、頻率和計分規則。20 個提示詞在三個引擎執行七天,最多會產生 420 個「提示詞 × 引擎 × 天」觀察。AI 回答會波動,這些不是完全獨立的統計樣本,而是用來測試重複性、缺少執行、證據保存與趨勢處理的實務資料。
在每款產品完成相同五項工作:
- 打開品牌缺席的提示詞,找出勝出的品牌和來源。
- 打開品牌有被提及、但自家網域沒有被引用的提示詞。
- 把品牌指名提示詞排除在探索指標之外,但保留回答。
- 從圖表變化追溯到造成變化的實際回答。
- 把一次失利轉成可指派的行動,並在下次檢討時重新找到它。
如果產品無法完成這個循環,再多一張摘要圖表也不會讓它真正可操作。
換工具時,哪些指標必須保留?
即使更換軟體,量度定義仍應可以帶走。至少要保留提示詞文字、主題、意圖分類、平台、語言、地區、執行時間、完整回答、偵測到的品牌、可見引用,以及該提示詞是否計入主要指標。
有了這些證據,AI 能見度指標才仍然可理解:
- 提及率: 提到品牌的符合條件回答 ÷ 已執行的符合條件回答。
- 引用率: 引用品牌網域的符合條件回答 ÷ 已執行的符合條件回答。
- 聲量佔比: 品牌提及在固定競爭組合總提及中的比例。
- 平均位置: 品牌在列出選項中的位置,並使用有文件記錄的計數規則。
- 情緒: 提到品牌的回答如何描述它,並以原文檢查分類。
- 推薦率: 把品牌列為合適選項的回答,與一般提及分開計算。
只有百分比、沒有提示詞和回答證據的匯出資料,不是真正的遷移路徑,而是一張團隊無法重現其方法的快照。
選擇方案前要確認什麼?
先測試會令資料失去用途的情況。工具能否區分使用者可見引用與背景讀取頁面?會不會把無引用或失敗的回答直接刪掉?能否修正品牌別名而不改寫歷史?語言與地區能否分開?修改提示詞時,趨勢是否有清楚分界?
再測試人的工作流程。讓週會負責人在沒有協助下完成一次檢討;讓內容負責人從一則輸掉的回答找出應修改的頁面;讓主管依保存的回答重現一個圖表數字。這些任務比功能清單更能反映採用難度。
最後計算真正的單位成本。提示詞限制背後是「提示詞 × 平台 × 地區 × 執行頻率」。應為團隊會持續維護的面板選方案,而不是為上手示範中的最大規模付費。AEO Mantis 的價格方案從五個 ChatGPT 提示詞的免費啟動掃描開始,清楚呈現後續擴充方式。
- 20 個提示詞在三個平台執行,每次會產生 60 則回答,因此評估提示詞上限時必須計入平台與地區倍數。
- 品牌提及、網域引用、推薦與位置是不同事件,不應壓縮成單一分數。
- 品牌指名提示詞若計入主要提及率,可能高估探索階段表現。
- 可辯護的趨勢必須固定提示詞、平台、語言、地區、頻率與計分規則。
- 最好的工具,是能把回答證據轉成團隊下一項負責行動的工具。
常見問題
實用名單可包括 AEO Mantis、Profound、Ahrefs Brand Radar、Semrush AI Visibility Toolkit、Peec AI 和 OtterlyAI。它們服務不同工作流程,因此應用相同提示詞、平台、語言、地區和證據要求比較。
至少應有提示詞控制、完整回答證據、分開的提及與引用指標、平台和市場篩選、競爭情境、來源分析、匯出,以及把缺口轉成負責行動的清楚流程。
先用 15 至 20 個涵蓋不同買家決策的提示詞,並在相同平台、語言和地區持續執行至少七天。
小型測試可以。把每個提示詞、回答、平台、日期、品牌提及和引用存入試算表。當定期執行、多平台追蹤、證據保存和團隊報告變得難以維護時,專用軟體才開始產生明顯價值。
問題已包含品牌名稱時,回答本來就較容易提及品牌。這些回答可保留作準確度與情緒檢查,但與探索指標分開,才能避免把容易取得的提及算成發現能力。