更新於 2026-07-06
AI 可讀性網站審核
AI 引擎要引用你的內容,首先必須能夠讀取網站。AEO Mantis 的網站審核會模擬 AI 爬蟲抓取頁面,找出阻礙引用的問題,包括無法存取的頁面、內容不足或難以擷取、缺少中繼資料和結構,並提供具體且按優先次序排列的改善建議。
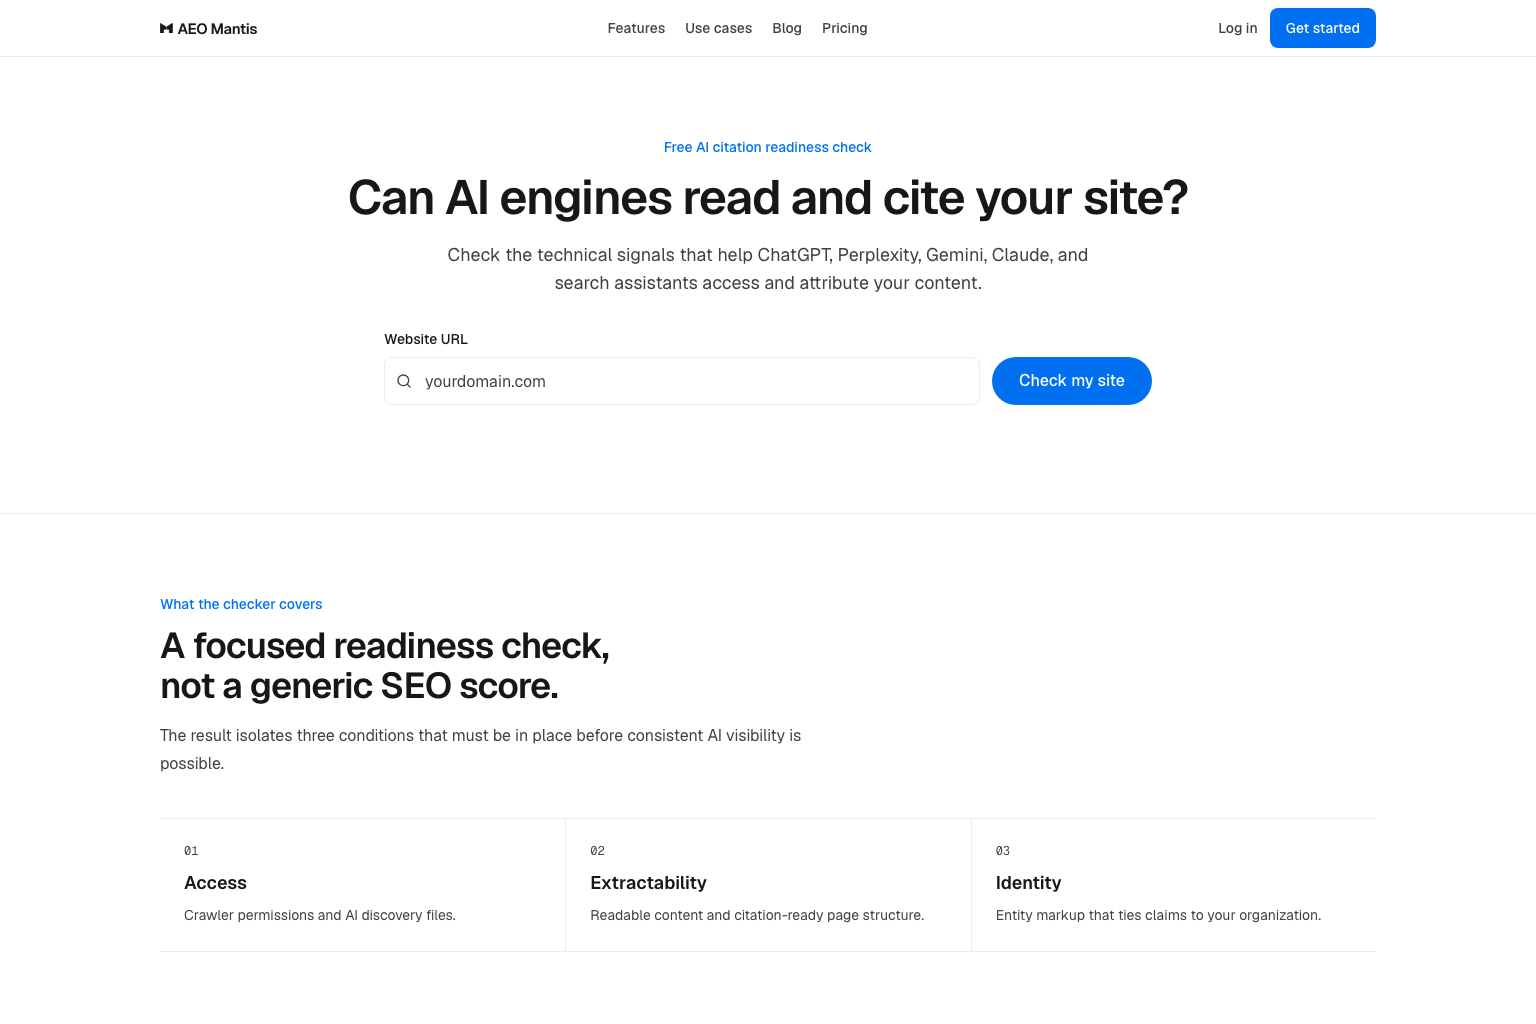
使用案例:診斷 example.com 為何未獲引用
Sample Brand 有一個實用的產品頁,但監測回答從未引用它。審核會檢查 AI 爬蟲能否抓取頁面、主要主張是否存在於可讀 HTML,以及中繼資料和實體訊號能否把主張連到正確品牌。結果會告訴團隊是否應先修正頁面,而不是立即新增內容。
逐步操作
1. 輸入你希望 AI 引擎引用的公開頁面
從應該回答監測問題的確切產品、比較、指南或文件 URL 開始。檢查器只接受公開 HTTP(S) 目標,並設有抓取上限和逾時控制。
2. 檢查存取、可擷取性和身分
存取檢查爬蟲權限與探索檔案;可擷取性檢查重要內容能否在不依賴脆弱客戶端呈現的情況下讀取;身分則檢查頁面是否清楚把主張連到組織,讓引擎正確歸因。
3. 優先修正影響最大的失敗
先修正擷取阻礙,再處理缺少答案優先區段、中繼資料、結構化資料或缺乏證據的主張。評分負責排序;個別發現負責解釋原因。
4. 把發現送入工作清單
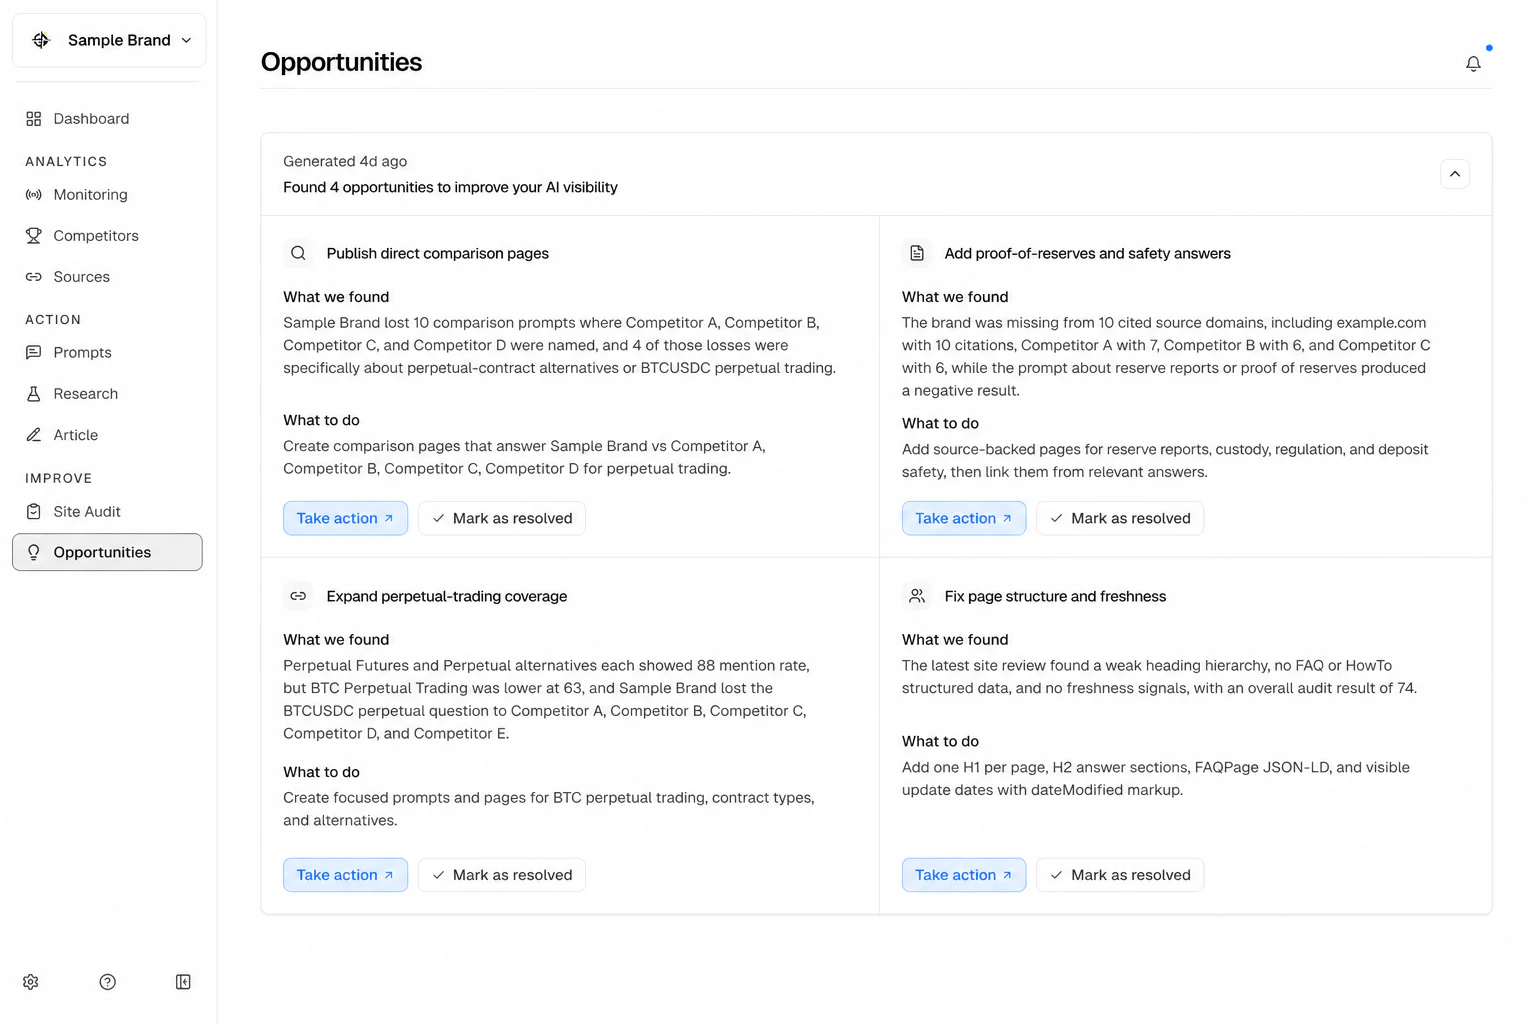
審核結果連同證據和建議修正加入改善機會。如果正確修正是新增內容,同一項工作可直接開啟內容流程,不會失去原始診斷。
為何 AI 可讀性是獨立問題
AI 爬蟲的限制通常比 Googlebot 更多:許多爬蟲不會執行 JavaScript、逾時時間較短,而且只會引用 HTML 中清楚可見的內容。即使頁面在傳統搜尋中排名良好,對答案引擎仍可能完全不可見。依賴客戶端呈現的內容、被封鎖的爬蟲,或隱藏在互動元件內的關鍵資料,都可能令擷取器看到空白頁面。
審核檢查什麼
- 可達性 — 爬蟲能否實際抓到關鍵頁:狀態碼、重新導向、robots 規則、回應時間。
- 內容結構 — 對應問題的標題、答案優先區段、可摘取主張相對於大段散文。
- 中繼資料與結構化資料 — 標題、描述,以及協助引擎分類頁面的 schema。
- 可引用性 — 頁面是否陳述引擎可直接引用的具體事實(引用機制)。
審核可設定深度和頁面數量上限,並為結果評分,讓影響最大的修正項目優先顯示。
只有當診斷結果指出需要新增頁面或內容區段,而非技術修正時,才使用內容生成。
- 以嚴格的安全、逾時和速率限制抓取,只檢查公開 HTTP 目標。
- 依影響為發現評分,讓修正被優先排序,而不只是列出來。
- 深度與頁數預算可依每次審核設定。
- 結果連到 Opportunities 與內容生成,直接處理修正本身。
常見問題
視角是 AI 擷取:對 JavaScript 的依賴、可摘取主張與答案優先結構更重要;部分傳統排名因素較次要。兩者都做——重疊但不互相取代。
不會——審核只抓有上限的頁數,並有逾時與速率紀律,且只針對公開 HTTP(S) URL。
每次執行由你選擇深度與頁數預算,受計劃上限約束。