更新於 2026-08-18
LLMO 是什麼?在生成式 AI 搜尋中獲得引用的實戰指南
LLMO(Large Language Model Optimization,大型語言模型優化)是讓 ChatGPT、Gemini 等生成式 AI 能正確理解、提及與引用品牌資訊的工作。它不會取代 SEO,而是在搜尋發現的基礎上,改善爬蟲存取、品牌資訊、答案結構與第三方佐證。成效要用固定提示詞組,分開追蹤提及率、引用率、推薦率與聲量佔比。
LLMO 沒有能保證曝光的神奇檔案、提示詞技巧或設定。Google 也明確指出,生成式 AI 搜尋仍以原有的 SEO 基礎與實用、原創內容為核心。實務上,最短路徑是依序讓資訊「讀得到、看得懂、能作為證據、可以量測」。本文會說明 LLMO 與 SEO、GEO、AEO 的關係,再整理六項對策與四週執行計畫。
什麼是 LLM SEO
LLMO 是持續改善品牌在生成式 AI 答案中被找到、理解、提及、推薦與引用的工作。範圍包含技術存取、品牌與產品說明、內容結構、站外資訊,以及答案層級的量測。
LLMO 是業界實務用語,不是單一官方標準。它與生成式引擎優化(GEO)及答案引擎優化(AEO)高度重疊。真正重要的不是名稱,而是團隊要經營哪些平台、用哪些指標判斷成果。
| 術語 | 主要目標 | 常用指標 |
|---|---|---|
| SEO | 在搜尋結果中被找到並獲得點擊 | 排名、曝光、點擊、自然搜尋轉換 |
| LLMO | 在 LLM 答案中被理解、提及與引用 | 提及率、引用率、推薦率 |
| GEO | 在多個生成式搜尋體驗中取得能見度 | 平台別能見度、聲量佔比 |
| AEO | 被選為問題的明確答案 | 答案版位、引用、精選摘要 |
SEO 是 LLMO 的基礎。頁面必須先被 Google 搜尋索引並符合摘要顯示資格,才可能成為 AI Overviews 或 AI Mode 的支援連結。ChatGPT 搜尋則需要確認 OAI-SearchBot 沒有被封鎖。滿足技術條件也不代表平台一定會收錄或引用。
AI 搜尋如何產生答案與引用
AI 答案可能使用訓練時學到的知識、回答當下從網路檢索的資訊,或兩者並用。不同平台與問題會使用不同來源與連結呈現方式。與其猜測未公開的排名公式,不如沿著可確認的基本流程改善。
1. 解讀問題。 AI 搜尋可以直接使用使用者的問題,也可能改寫成更具體的搜尋查詢。OpenAI 說明,ChatGPT 搜尋可能把一個問題改寫成多個目標查詢,再送往搜尋合作夥伴。
2. 取得相關頁面。 對以搜尋為基礎的答案而言,平台索引或爬蟲能存取的公開頁面才可能成為候選來源。Google 的生成式搜尋使用核心搜尋系統;ChatGPT 搜尋是否能在摘要與片段中納入網站內容,則會受到 OAI-SearchBot 存取設定影響。
3. 選擇答案資訊。 各服務會用自己的系統評估檢索到的資訊。相關性、清楚程度、可靠性與新鮮度都可能影響結果,但詳細選擇公式並未公開,符合條件也不保證會出現。
4. 生成答案與連結。 系統整理選出的資訊,並可能顯示支援連結或參考來源。同一提示詞在不同時間可能得到不同答案與引用,因此固定提示詞的持續量測比單次抽查更可靠。
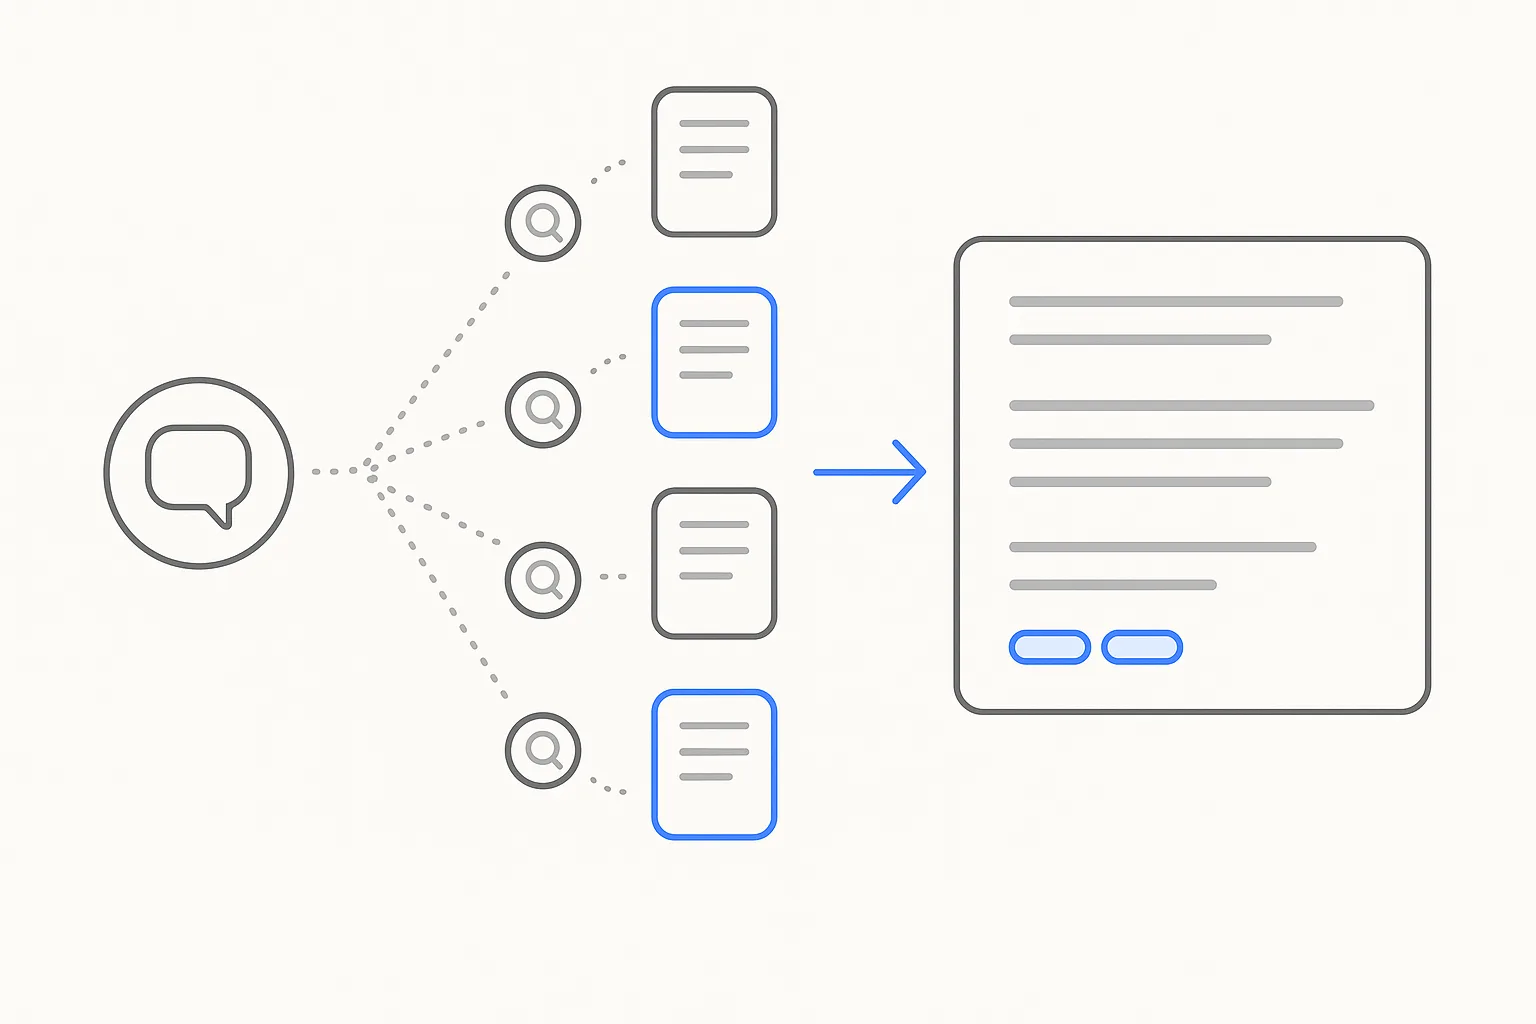
實務工作者能改善兩件事:頁面是否能被取得,以及資訊被找到後是否好用。具體來說,就是可靠的爬蟲存取、一致的品牌資訊、直接回答問題的內容、可驗證的證據,以及站外資料與官方說法一致。
LLMO 怎麼做:六項實務對策
下面每一項都不炫,而這正是重點:沒有一項需要成長駭客的花招,只需要把紮實的內容發布功夫,用在引擎真正會看的地方。請按順序做——每一項都會放大下一項的效果,前面的弱點則會封住後面所有努力的上限。
1. 機器可存取性——爬蟲、robots 與 JavaScript
存取。 抓取器讀不到你的內容,你對引擎就不存在。確認 robots.txt 與 meta robots 允許相關的使用者代理——一般搜尋爬蟲與 AI 專用爬蟲——抓取關鍵頁面,並留意資料夾層級過寬的 disallow 悄悄擋掉文件或價格頁。AI 爬蟲存取基準測試提供五隻主要代理之間可重現的跨網站比較。
伺服器行為。 用無頭抓取測試頁面:回傳 200 狀態碼、正確的內容類型、不依賴客戶端渲染的完整 HTML。若主要內容依賴 JavaScript,請提供伺服器端渲染或預渲染快照。AI 可讀性檢測存在的原因正是:在瀏覽器裡看起來正常的頁面,對爬蟲而言常常是一片空白。
Sitemap 與 feed。 提供 lastmod 準確的 XML sitemap,並為文件與更新日誌開放 RSS/Atom feed 作為新鮮度訊號。
穩定性。 減少會擋住自動化客戶端的插頁、同意牆與速率限制。資源載入太慢,無頭渲染器會逾時並判定頁面是空的。
2. 實體清晰度
消歧。 如果品牌名稱與產品、公司或一般名詞相同,AI 答案可能混淆不同實體。請在網站與外部檔案中統一正式名稱、描述與標語,並在容易混淆的頁面加上一句區分說明。
結構化訊號。 用 Organization 與 Product 標記宣告名稱、別名與 sameAs 關係,帳號與網域保持一致。具體做法見 AI 引擎如何認定你「就是你」。
著陸頁對齊。 給每個實體一個穩定的網址,用容易掃讀的區塊回答「這是什麼」「給誰用」「怎麼用」,並把相關實體互相連結,讓分群站在你這邊。
3. 可引用的結構
可獨立引用的內容單元。 引擎偏好不需要整頁脈絡就能取用的段落:一句話的定義、編號步驟清單、精簡的比較列、明確的價格或限制。把它們放在頁面前段,並清楚標示。
答案優先的寫法。 讓模型不用捲動就能取出答案:問句形式的小標、短段落、帶有明確陳述與具體數字的摘要區塊。完整的寫作原則見如何寫出 AI 引擎真正會引用的內容。
摩擦。 內容必須在沒有 cookie 牆、電郵門檻或阻擋文字擷取的腳本下依然可讀——而且標準版本要是最乾淨的那一個。
4. 佐證與第三方存在
跨網域事實一致。 只出現在自家行銷文案中的資訊,較難讓讀者與 AI 系統交叉確認。公司名稱、類別、功能與價格等核心事實,應在官方檔案、合作夥伴與相關目錄中保持一致。目標是事實一致,不是複製宣傳文字。
證據深度。 每一項主張都應有清楚的一手來源:規格放在技術文件、限制放在支援文章、最新金額放在價格頁。自家網站與正確的站外檔案一致,也能減少過期資訊與品牌混淆。
敘事形態。 許多提示詞以「最適合 Y 的 X」「Z 的替代品」「X 與 Y 比較」的形態出現。確保這些比較框架存在於可被檢索的地方,陳述乾淨、不誇大。
5. 新鮮度與可檢索性
更新路徑。 即時檢索型引擎會重訪 sitemap 與 feed。lastmod 與 pubDate 要準確,頁面上保留可見的「最後更新」標示,讓被擷取的段落自帶新鮮度線索。
HTTP 健全度。 標準網址保持穩定、必要搬遷用 301、避免軟 404。同一事實在不同頁面不同步——一頁是舊價格、另一頁是新價格——會讓讀者與機器都更難信任網站。
檢索人體工學。 想被抓取的索引頁避免無限捲動;提供有明確上一頁、下一頁連結的分頁封存。
6. 各平台行為差異
ChatGPT。 開啟瀏覽時會跨網路來源扇出,並顯示數量有限的行內引用,技術類查詢偏好精簡的定義段落與文件。針對它的具體戰術見如何獲得 ChatGPT 引用。
Google AI Overviews 與 AI Mode。 兩者混合語料知識與以 Google 索引為基礎的即時檢索,傳統的抓取與品質要求大多沿用——但引用單位是一段答案,不是一個排名列表。運作方式見 AI Overviews。
Gemini、Perplexity、Bing Copilot。 各有不同的檢索器、介面限制與引用政策:有的優先網域多樣性、有的更看重新鮮度、有的把參考來源放在文末而非行內。同一個提示詞會得到不同結果——把每個引擎當成獨立通路經營,它們共享的是同樣四個輸入:存取、實體清晰度、可引用結構、佐證。
LLMO 怎麼開始:四週實戰計畫
LLM SEO 可以用緊湊的四週循環來跑,跑完再重來。這個節奏讓你貼近買家真正在問的提示詞上可量測的變化。
如果這週你只有一個小時,就做第一週的最小版本:挑十個買家提示詞、在兩個引擎上跑一遍、把答案存到之後找得到的地方。單是這份基準——誰被點名、誰被引用、你在哪裡缺席——通常就足以改寫整份內容路線圖,後面的一切只是把它放大。
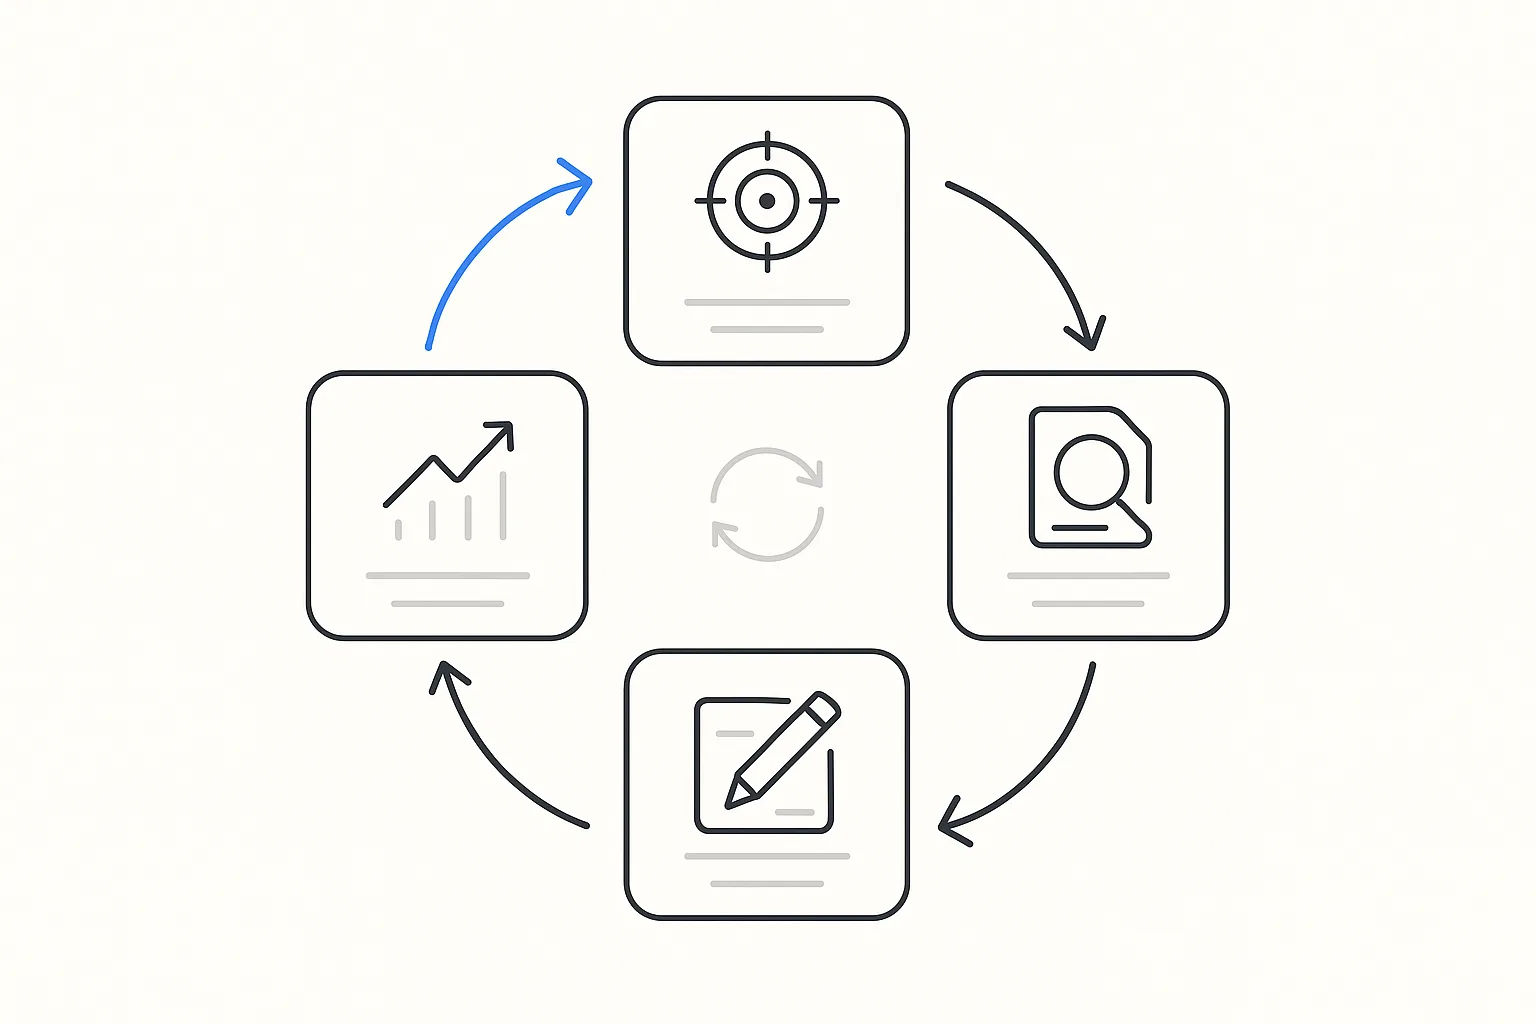
第一週——基準與提示詞集合
定義提示詞集合。 從 10–25 個代表商業版圖的提示詞開始:「什麼是〔類別〕」「最適合〔客群〕的〔類別〕」「〔競品〕替代品」「〔品牌〕與〔競品〕比較」。挑選方法見如何找出買家真正會問 AI 的提示詞。
建立基準。 對每個在意的引擎,記錄答案內容、引用了哪些來源、你的品牌是被提及、被連結還是被推薦。證據要留存——打不開的答案,就是辯護不了的數字。
量化。 按引擎、按意圖分組計算整組提示詞的引用率與聲量佔比。這個基準是後續一切的分母。
第二週——存取與實體稽核
可抓取性。 針對應該贏得引用的頁面,驗證 robots.txt、canonical、sitemap 覆蓋與伺服器回應,並用無頭客戶端抓取,確認內容不靠 JavaScript 也能完整渲染——網站檢測可以把這份清單自動化。
實體一致性。 統一名稱與描述語、更新 Organization 與 Product 標記、在需要處加上消歧句,並互相連結實體頁面。
檢索表面。 確保文件、價格與比較頁以第一級網址存在、標題清楚,經常變動的內容開放 feed。
第三週——針對缺口發布
補上定義缺口。 為你的類別與產品建立或重構「什麼是〔X〕」區塊;加入可直接擷取的比較列與明確數字。
建立佐證。 更新反映標準描述的第三方列表,並提供合作夥伴一段標準文案與正確連結。
拆分過載頁面。 一個網址想回答太多意圖時,把它拆開,讓每一頁乾淨對應一個提示詞群,標題與 H1 對齊你鎖定的提示詞用語。
第四週——重新量測與修正
重跑提示詞集合。 按引擎與提示詞群比較引用率、聲量佔比的變化;檢視你在哪裡被加入、在哪裡被剔除、輸給了哪些來源。
診斷落選。 對缺席的提示詞依序檢查:抓取器到得了頁面嗎、頁面有可獨立引用的單元嗎、主張在其他地方有佐證嗎?失敗幾乎都出在這三件事之一。
鎖住循環。 把診斷結果變成下一輪的發布清單,維持每月重新量測的節奏,每週保留一個時段做小型快贏——收緊一句定義、更新一個過期數字。
LLMO 成效怎麼量測
搜尋排名無法單獨衡量 LLMO。先建立一組真實買家會使用的固定提示詞,並維持平台、語言、地區與執行頻率不變。四項主要指標要分開追蹤:
- 提及率: 合格答案中出現品牌名稱的比例。
- 引用率: 合格答案中出現品牌網域連結的比例。
- 推薦率: 答案把品牌列為選項、比較對象或推薦服務的比例。
- 聲量佔比: 在已定義的競爭集合中,自家品牌提及占全部品牌提及的比例。
用 7 天變化找出漏跑與突然的答案變動,再用 28 天變化判斷方向。數字改變時,要回到原始答案、引用網址、平台與執行時間,再判斷原因。計算方式與報表範例可參考 AI 能見度指標。
需要 LLMO 工具嗎?
範圍小的時候可以純手動:一、二十個提示詞、一兩個引擎、按排程檢查、證據存進試算表。這句話反過來也成立——引擎、提示詞、地區與關係人一多,手動流程就會崩潰,不是方法變了,而是記帳量變了。
工具帶來的是規模化的可重複性:跨主要引擎的排程執行、證據留存、按引擎彙整的聲量佔比與引用率、按提示詞群的缺口偵測。AEO Mantis 把這些做成單一工作流,涵蓋 ChatGPT、Gemini、Perplexity、AI Overviews、AI Mode 與 Bing Copilot——免費方案與付費方案的分界見價格。
- LLMO 不會取代 SEO。Google 的生成式搜尋仍以可索引頁面與實用、原創內容為基礎。
- 若要讓內容可出現在 ChatGPT 搜尋,請確認沒有封鎖 OAI-SearchBot;它與 GPTBot 的訓練控制用途不同。
- 清楚的定義、比較列、步驟與一手證據,能讓人與機器更容易辨識有用的答案段落。
- 答案與引用會隨執行變動,因此要固定提示詞、語言、地區與平台並定期量測。
- 提及率、引用率、推薦率與聲量佔比要分開計算,並保存原始答案與引用網址。
常見問題
兩者高度重疊。LLMO 以大型語言模型為中心描述這項工作,GEO 則著重更完整的生成式引擎體驗。團隊更該統一目標平台與量測指標,而不是爭論名稱。
重要。頁面必須先被 Google 搜尋索引並符合摘要顯示資格,才可能成為 AI Overviews 或 AI Mode 的支援連結。可抓取性、內部連結、實用原創內容與正確資訊仍是基礎。
對會瀏覽網路的引擎,存取、結構與內容的改善在重新抓取後數天到數週內就可能反映。倚賴模型記憶的答案則要等下一次訓練週期。以每月為單位量測,才是看見整組提示詞穩定變化的務實節奏。
小規模可以:固定提示詞集合、一兩個引擎、每週排程、把證據有紀律地存進試算表。當提示詞、引擎或關係人變多,手動記帳開始漏跑、丟證據時,工具就值回票價。
從買家實際做功課的地方開始:多數團隊是 ChatGPT 與 Google 的 AI 搜尋體驗優先,其次是 Perplexity 或你所在利基偏好的引擎。先用小型提示詞集合試點驗證,再把力氣鋪到全部六個支援平台。
值得,特別是在特定用途與產業問題上,品牌能提供具體一手證據、清楚產品資訊或可驗證案例時。不過曝光並不保證,應聚焦重要提示詞並持續量測提及與引用。